技术层面探讨 日本站群对于多店管理与数据同步的实现方式
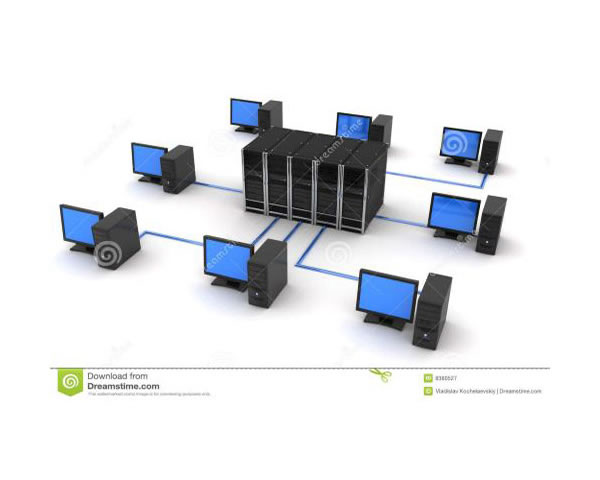
问题一:在日本站群环境中,如何设计站群架构以支持多店管理并兼顾性能与可维护性?
在设计日本站群架构时,首要目标是实现可扩展的多店管理,同时满足日本用户的访问性能与搜索引擎合规要求。常见做法是采用“多域名多店(multi-domain multi-tenant)”或“单域名子目录/子域多店”两种模型。对于强调品牌与SEO独立性的场景,建议为每个店铺使用独立域名或二级域名;若更侧重统一运营与共享内容,则可考虑子目录方案。
关键组件应包含哪些?
核心组件包括:统一的认证与权限中心(SSO)、多店配置管理中心、可插拔的支付与物流服务、头部缓存/CDN、以及集中化的日志与监控系统。为了支持日本站群的地域需求,建议在日本(或靠近日本的机房)部署边缘节点与数据库只读副本。
技术实现细节(性能与隔离)
在数据库层面可采用分库分表或逻辑多租户(tenant_id),并为写密集业务设置主库,读操作走只读副本;业务隔离可使用容器化(Kubernetes)按店铺或按业务模块部署服务。缓存方面可用Redis集群实现热点数据本地化;CDN缓存静态资源与页面缓存,降低源站压力。
落地建议
先从最小可行多店模型起步(例如同一后台配置不同店铺),逐步拆分成独立服务。并在日本设立监控告警(RTT、错误率),确保本地用户体验。
问题二:通过哪些同步策略可以在站群间保持商品、库存、订单等数据的一致性?
数据同步策略分为强一致、弱一致与最终一致三类。对于库存与支付类强一致场景,需要在线事务或分布式事务策略(尽量减少跨站分布式事务)。更多场景采用最终一致性:通过事件驱动(Event-Driven)或消息队列(如Kafka、RabbitMQ)异步同步,各站订阅变更事件并更新本地数据。
常见同步实现手段有哪些?
1)基于消息队列的事件广播;2)基于数据复制(如MySQL binlog)做近实时同步;3)定时批量同步(批处理/ETL),用于不敏感数据;4)API调用+Webhook,用于跨系统即时通知。
性能与可靠性的考虑
消息中间件需要保障幂等与重试机制;事件结构建议包含全量与增量两类消息。对库存扣减等关键操作应设计乐观锁/悲观锁或基于库存服务的单点写入,避免并发超卖。数据同步链路需监控延迟、积压(queue lag)与失败率。
落地建议
核心商品与库存数据采用事件驱动+幂等消费;历史数据与统计可用每日批处理。为关键操作实现补偿流程与人工回溯接口。
问题三:如何在日本站群中处理域名/IP、SEO与搜索引擎友好性问题以避免被识别为“站群”滥用?
日本站群在SEO上需小心避免被搜索引擎判定为垃圾站群。要做到搜索引擎友好,首先需保证每个站点有独立且高质量的内容、适当的地理定位(hreflang、地域化内容)以及自然的站点间链接策略。不要通过大量重复内容或过度互链来构造权重。
具体SEO技术要点有哪些?
使用 hreflang 标记指定日语(jp)或地区版本,确保 canonical 标签指向正确的版本,避免重复索引。每个站点应有独立XML sitemap并提交给Google/Bing等搜索引擎的站长工具。对于日本市场,注意语言编码与本地化关键词。
域名/IP与托管策略
建议将站点托管在日本或邻近的CDN节点以提升访问速度;域名分配可以混合使用不同注册商与不同IP段的CDN出口,避免全部站点集中在同一IP导致异常风险。此外,WHOIS信息与服务器指纹要保持合理多样化。
落地建议
每个店铺都应有独立内容策略并遵循搜索引擎规范。采用分散化的托管和CDN策略,同时保持合规的站群姿态。
问题四:在数据冲突与一致性异常发生时,如何定义冲突解决策略与回滚机制?
针对并发写入或同步延迟导致的冲突,需要事先设计冲突解决策略。常见策略包括基于时间戳的最后写优先(LWW)、基于优先级的来源信任度、或者基于向业务侧人工确认的冲突合并。对关键业务(订单、支付)应尽量避免异步最终一致导致的数据冲突。
冲突检测与合并方式
通过在数据模型中加入版本号(version)或变更ID(change_id)进行乐观锁控制;消费端在处理事件时检查版本一致性,若冲突则触发补偿逻辑或将冲突写入待处理队列交由人工或自动化规则合并。
回滚与补偿技术实现
实现事件溯源(event sourcing)可以方便回滚到历史状态;对于无法回滚的外部行为,设计补偿事务(compensating transactions)来逆向操作。日志与审计非常重要,建议保存操作链路以支持回溯与问题定位。
落地建议
为高风险操作实现同步接口或分布式锁,将异步操作限定在可补偿范围内;并建立冲突报警与人工干预流程。
问题五:如何做好日本站群的数据安全、监控与运维,确保同步链路稳定且可追溯?
数据安全与运维是站群长期稳定的基础。应实现加密传输(TLS)、细粒度权限控制(最小权限)、敏感数据脱敏与访问审计。同步链路需能追踪每条消息的状态,做到可重放与幂等。
监控与告警应覆盖哪些维度?
监控维度包括:消息队列长度/延迟、数据库复制延迟、API错误率、页面响应时延、CDN命中率、以及日志异常(异常请求/安全攻击)。同时设置SLO与自动化告警策略以便及时响应。
可观测性与追踪设计
采用分布式追踪(如OpenTelemetry)、链路日志与结构化日志,关联事务ID以便从前端请求追溯到异步同步事件。为消息与事件添加唯一ID与元数据,便于幂等处理与错误重试。
落地建议
建立基线与演练(故障演练、回滚演练),定期审查同步策略与安全策略;并为关键同步接口提供回放工具与数据修复脚本,保证运维效率。
-
亚马逊日本站测评群: 优质商品的不二选择
亚马逊日本站测评群: 优质商品的不二选择 亚马逊日本站作为全球知名的电商平台,拥有丰富的商品种类和优质的购物体验,成为许多消费者的首选。在这个庞大的市场中,测评群的存在为消费者提供了一个寻找优质商品的不二选择。 亚马逊日本站测评群是由一群热爱分享购物心2025年2月11日 -
日本站群服务器特点在安全合规与数据保护上的体现
1.概述:日本站群部署的安全与合规背景 (1)日本站群通常指在日本境内多个机房或多个IP段(Anycast/独立IPv4)部署的服务器群,用于分担流量、提升访问速度并实现冗余。 (2)在安全合规层面,运营者需遵循《个人信息保护法》(APPI),以及国际性标准如ISO27001或SOC2做为合规背书。 (3)数据主权与备份策略在日本尤为重要:多数企业2026年8月28日 -

无货源店群如何在日本站实现快速盈利
无货源店群的模式在近年来的电商行业中愈发流行,尤其是在日本站这样竞争激烈的市场中,如何实现快速盈利成为了众多创业者关注的焦点。以下是关于如何在日本站通过无货源店群实现盈利的五个常见问题及其解答。 1. 什么是无货源店群? 无货源店群是一种电商模式,商家不需要自己囤货,而是通过与供应商合作,将产品信息上传到电商平台上。当有客户下单时,商家再从供2025年12月29日 -

亚马逊日本站qq群危机公关方案舆情监控与快速响应模板
1. 概述:技术化舆情监控的必要性 1) 针对亚马逊日本站 QQ 群传播速度快的特点,必须把舆情监控做在网络层与应用层,结合 CDN、WAF 和日志采集; 2) 在事件发生时,服务器(VPS/主机)性能直接决定应对窗口,优先保证 origin 的可用性与横向扩容能力; 3) 域名解析策略(DNS)与 CDN 缓存策略能在短时间内吸收大规模请求,减2026年6月29日 -
日本站亚马逊交流群名称精选
日本站亚马逊交流群名称精选 亚马逊是全球最大的电子商务平台之一,每天都有成千上万的卖家在亚马逊上开展业务。在日本,亚马逊也是非常受欢迎的购物平台。为了方便卖家之间的交流与互助,许多人创建了各种各样的交流群。本文将为您介绍一些日本站亚马逊交流群的精选名称。 这个群是日本站亚马逊卖家之间最为活跃的交流群之一。卖家们可以在这个群里分2025年3月1日 -
日本站亚马逊商家群:商机无限
日本站亚马逊商家群:商机无限 亚马逊作为全球最大的电子商务平台之一,吸引了全球各地的商家和消费者。其中,日本站的亚马逊商家群体更是庞大而活跃。日本站亚马逊商家群,以其无限的商机和潜力,吸引了越来越多的商家加入。本文将介绍日本站亚马逊商家群的特点和商机。 1. 多元化的产品种类:亚马逊日本站上有各种各样的产品,包括电子产品、2025年3月30日 -
日本站群多IP:SEO必备的关键策略
日本站群多IP:SEO必备的关键策略 随着互联网的发展,SEO(Search Engine Optimization)已经成为网站推广的重要手段之一。在日本,站群多IP是一种常见的SEO策略,本文将介绍站群多IP的重要性以及如何有效运用这一策略。 站群多IP是指在不同IP地址上部署多个网站,通过互相链接和引流的方式提升2025年5月9日 -
日本站群多IP解析与优化技巧
日本站群多IP解析与优化技巧 在进行网站优化时,站群多IP解析是一个重要的考虑因素,尤其对于日本站点来说。本文将介绍一些日本站群多IP解析与优化的技巧。 站群多IP解析是指在一个站群中,为每个网站分配多个IP地址,以提高网站的可用性和稳定性。通过多IP解析,可以使网站在遭受2025年3月4日 -
日本站亚马逊QQ群:快速入群购物指南
日本站亚马逊QQ群:快速入群购物指南 加入日本站亚马逊QQ群,可以享受以下好处: 及时获取日本站亚马逊的促销信息和优惠活动。 与其他购物爱好者分享购物心得和推荐商品。 解答购物中遇到的问题,并获得其他群友的帮助。 了解最新的日本站亚马逊购物攻略和福利。2025年5月5日